القاهرة –  التالتة
أفضل ذكاء اصطناعي يتحدد بالمهمة: ChatGPT للتنوع، وClaude للعمل التقني، وGemini لتكامل جوجل، وJasper للتسويق، مع موازنة الجودة والتكلفة وحدود الاستخدام اليومية.
يتطلب البحث عن أفضل ذكاء اصطناعي مقارنة جودة الإجابات بحدود الاستخدام وملاءمة الأداة لطريقة عملك. فقد تمنحك أداة مسودة ممتازة، ثم تصل إلى حد الاستخدام قبل إكمال المشروع، وقد تتصدر أخرى اختبارًا تقنيًا دون أن تناسب طريقة عملك. وتساعد موازنة الخيارات المستخدم في السعودية على اتخاذ قرار الاشتراك، ويضيف تحليل التالتة أن الاقتراب من أعلى جودة قد يكون أوفر من مطاردة أعلى نتيجة، استنادًا إلى أمثلة من تقييمات Anthropic على أداء مماثل أو متقارب بنصف التكلفة، أو 40% منها، أو أقل من عُشرها، بما يتيح اختيار أفضل ذكاء اصطناعي بحسب تكلفة بلوغ الجودة المطلوبة للمهمة.
تعتمد المقارنة على رصد التالتة الآلي للأسعار والمواصفات والآراء الموثقة، وربطها بوثائق الشركات ونتائج الاختبارات المنشورة. وترتبط قيمة الاشتراك بقدرة الأداة على إنجاز عملك بالجودة المطلوبة مقابل ما تدفعه.
الخلاصة السريعة: ما أفضل ذكاء اصطناعي بحسب استخدامك؟
ترشيح التالتة لمن يبحث عن أفضل ذكاء اصطناعي هو البدء بأداة عامة تناسب مهامك المتكررة، ثم الانتقال إلى أداة متخصصة عندما تقدم فائدة واضحة.
يتقاسم GPT-6.2 Astra وClaude Fable 5.2 صدارة الترتيب العام لاختبار LiveBench 2.0 بدرجة 84.9 لكل منهما، بينما يتصدر GPT-6.2 Astra اختبار البرمجة بدرجة 91.9. ويتصدر Claude Fable 5.2 أيضًا لوحة Arena WebDev القائمة على تصويت البشر، بحسب Fello AI1.
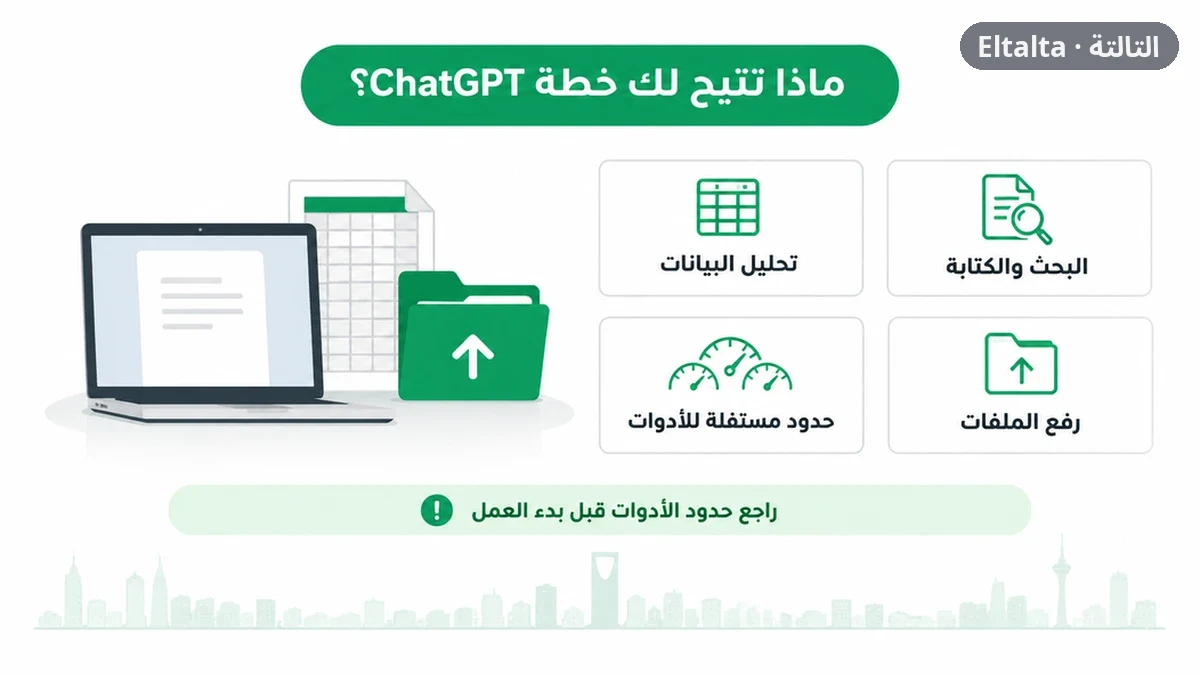
- للاستخدام المتنوع: يمثل ChatGPT نقطة بداية عملية؛ لأن OpenAI2 تتيح في خطته المجانية البحث على الويب وتحليل البيانات ورفع الصور والملفات، وهو تنوع قوي لمن يجمع بين الدراسة والكتابة والعمل المكتبي، مع حدود منفصلة للأدوات. (help.openai.com2)
- للبرمجة والمشروعات التقنية: يستحق Claude المقارنة الجادة؛ فقد نشرت Anthropic3 نتائج متقدمة لنموذج Fable 5.2 في البرمجة والاستدلال والرؤية، ما يجعله مرشحًا قويًا للعمل التقني، دون أن يمنحه تلقائيًا صدارة جميع الاستخدامات. (anthropic.com3)
- للعمل المرتبط بخدمات جوجل: يناسب Gemini من تعتمد مهامه على هذه البيئة، بشرط مراعاة إتاحة كل ميزة؛ إذ توضح Google4 اختلاف شروط الطرح بحسب البلد والحساب واللغة. (gemini.google4)
- لفرق التسويق: يستحق Jasper AI الاشتراك عندما تحتاج المؤسسة إلى تنظيم الحملات والتخصيص والتوطين والحوكمة، وهي وظائف تعرضها Jasper في بيانها المنشور عبر TMCnet5، وتمنحه قيمة أقوى للفريق مقارنة بمن يكتب نصوصًا متفرقة. (tmcnet.com5)
- لتوليد الصور: يدخل DALL-E ضمن الخيارات المتخصصة؛ وتعرض 3arabi.ai6 قدراته في تحويل الأوصاف إلى صور بأبعاد مختلفة، وهي فائدة مباشرة للتصورات الإبداعية، مع ضرورة مراجعة التفاصيل والنصوص قبل النشر.
النتيجة: لا يحتاج المستخدم إلى الاشتراك في جميع هذه الأدوات. الأداة المناسبة هي التي تغطي الجزء الأكبر من عمله، ثم تبرر أي أداة إضافية تكلفتها بوظيفة محددة.
معايير المقارنة: ما الذي يحسم الاختيار؟
تحسم الاختيار أربعة معايير مترابطة: ملاءمة المهمة، وإمكان الوثوق بالنتيجة، واستمرارية العمل، والقيمة مقابل التكلفة.
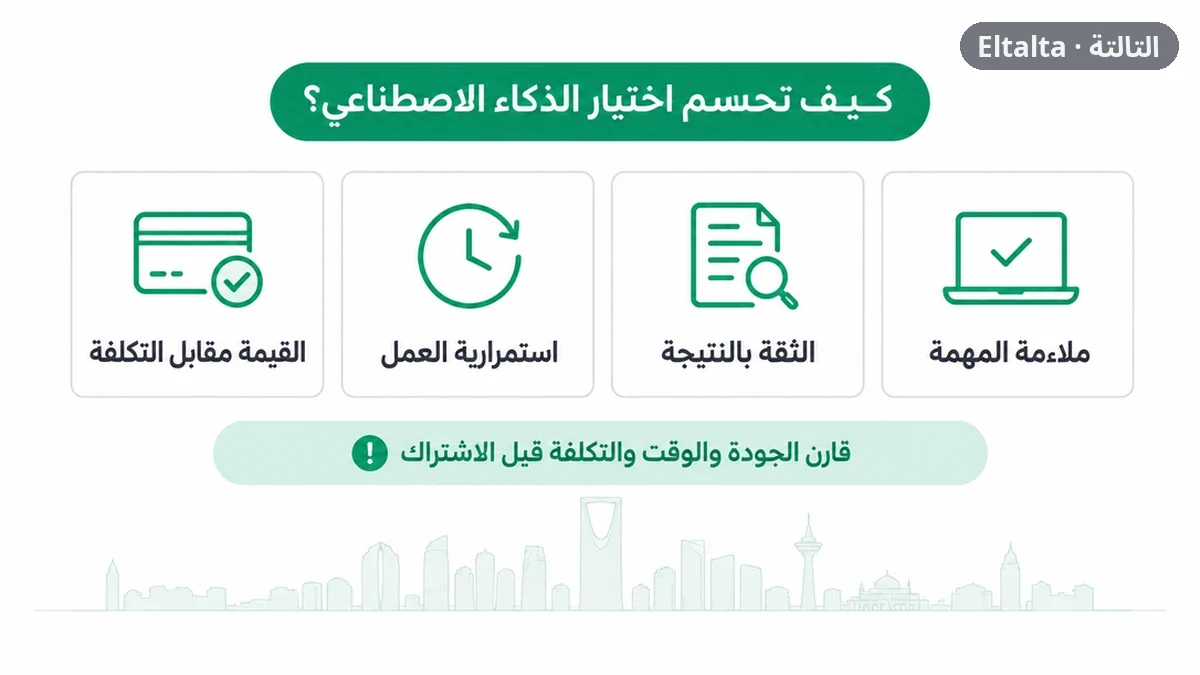
ملاءمة المهمة تعني تحديد أفضل ذكاء اصطناعي بناءً على تفوقه في العمل الذي تحتاجه فعلًا. فإنتاج صورة إعلانية يختلف عن مراجعة برنامج أو إعداد بحث موثق.
الثقة تعني أن تستطيع مراجعة الإجابة. قد تكفيك مسودة قابلة للتحرير لرسالة بريدية، لكن مقارنة مواصفات منتجين تحتاج إلى مصادر أصلية، لا إلى صياغة مقنعة وحدها.
الاستمرارية تعني أن تتمكن من إكمال المهمة ضمن حدود خطتك. وتوضح Anthropic7 أن استهلاك Claude يتأثر بطول المحادثة وتعقيدها والميزات والنموذج ومستوى الجهد؛ لذلك يصنف التالتة الاعتماد على عدد الرسائل وحده معيارًا محدودًا لتقدير يوم عمل كامل. (support.claude.com7)
القيمة تعني حساب الوقت والتعديلات والتوقفات إلى جانب مبلغ الاشتراك. من واقع خبرتنا مع العملاء والمستخدمين، يتضح لنا أن اختيار أفضل ذكاء اصطناعي على أساس السعر الأقل قد يصبح أغلى عمليًا إذا احتجت إلى إعادة العمل مرارًا.
وبناءً على تحليل فريق التالتة، تكون المقارنة مفيدة عندما تبدأ من مهمة واضحة ومعيار قبول محدد، ثم تربط النتيجة بالوقت والتكلفة.
جدول المقارنة: أبرز الأدوات وما الذي يميز كلًا منها؟
وبهذا الصدد، توضح مقارنة أفضل ذكاء اصطناعي أن الاختلاف الأساسي بين الأدوات يتعلق باتساع الوظائف ودرجة التخصص وشروط مواصلة العمل.
| الأداة | أبرز استخدام مناسب | نقطة القوة في المادة الموثقة | القيد المؤثر | حكم التالتة |
|---|---|---|---|---|
| ChatGPT | الكتابة والبحث وتحليل البيانات والملفات | تجمع خطته المجانية أدوات متعددة وفق OpenAI2 | حدود الأدوات مستقلة عن المحادثات النصية | قوي كنقطة بداية عامة |
| Claude | البرمجة والعمل التقني | نتائج Fable 5.2 المنشورة لدى Anthropic3 | يتغير الاستهلاك بحسب المهمة والنموذج والجهد | قوي تقنيًا مع حساب الاستمرارية |
| Google Gemini | العمل ضمن خدمات جوجل والوسائط المختلفة | توسع المهام والتكاملات وفق Google4 | إتاحة بعض الميزات مقيدة جغرافيًا | قوي عند توافق التكامل مع حسابك |
| Jasper AI | إنتاج المحتوى التسويقي على مستوى الفرق | الحملات والتخصيص والحوكمة وفق Jasper5 | تقل فائدته الإضافية للاستخدام الفردي البسيط | قوي للتسويق المنظم |
| DALL-E | توليد الصور من الأوصاف | التحكم في الموضوع والأسلوب والتكوين وفق Productory8 | التفاصيل المطلوبة تحتاج وصفًا واضحًا ومراجعة | قوي للتصورات الإبداعية |
| DeepSeek | بديل للمحادثة والاستدلال | وثقت الجزيرة نت9 أداء R1 التنافسي في فبراير 2025 | المقارنة التاريخية لا تحسم وضع النماذج الحالية | خيار للمقارنة الاقتصادية، دون تعميم ترتيب قديم |
النتيجة: المقارنة العادلة تجمع بين جودة الإجابة وطريقة الوصول إليها. كما تفصل بين المساعد العام، ومنصة التسويق، ومولد الصور.
الاختبار الموحد: كيف تقارن المساعدات الأربعة عمليًا؟
يمكنك تحديد أفضل ذكاء اصطناعي بمقارنة ChatGPT وClaude وGemini وDeepSeek عبر المهام نفسها، مع تثبيت المدخلات وتسجيل الخطة والنموذج والتاريخ.
يقترح التالتة الخطوات التالية بوصفها طريقة لاتخاذ قرار الاشتراك:
- حدد المهام: اجمع طلبًا بحثيًا، ونصًا عربيًا، ومشكلة برمجية، وملفًا أو صورة من طبيعة عملك، بحسب الميزات المتاحة في كل أداة.
- وحّد المواد: قدم النصوص والملفات والتعليمات نفسها، وحدد الطول والشكل المطلوبين.
- حدد الإجابة المقبولة: ضع قائمة بالحقائق أو الوظائف التي ينبغي أن تتضمنها النتيجة.
- افحص الصحة: افتح المصادر، وراجع الأرقام، وشغّل الشيفرة في بيئة مناسبة.
- اطلب تعديلًا: اختبر قدرة المساعد على تصحيح خطئه والمحافظة على بقية المطلوب.
- سجل الاستمرارية: دوّن وقت الإنجاز، وعدد المحاولات، وأي حد استخدام أوقف المهمة.
- احسب القيمة: اربط النتيجة النهائية بما دفعته والوقت الذي وفرته.
وفي هذا السياق، ينبه دليل Anthropic7 إلى أثر تعقيد المحادثات ومستوى الجهد على الاستهلاك. ويعني ذلك، بتحليل التالتة، أن مقارنة محادثة قصيرة لدى أداة بمشروع طويل لدى أخرى تمنح انطباعًا محدودًا عن استمرارية العمل. (support.claude.com7)
النتيجة: أفضل ذكاء اصطناعي لك هو الذي ينجح في المهمة والتعديل والمتابعة، لا الذي يكتب أجمل إجابة افتتاحية.
نتيجة كل معيار: من يتقدم في الجودة والثقة والاستمرارية؟
يتغير المتقدم بحسب المعيار؛ فالنتائج المنشورة تدعم أحكامًا محددة، وتختلف قوتها عن ترتيب شامل لكل المساعدات.
جودة الأداء: ماذا يخبرك ترتيب النموذج؟
ومع ذلك، يخبرك الترتيب بأداء إصدار محدد في اختبار محدد، وهو معيار محدود لاختيار أفضل ذكاء اصطناعي لعملك اليومي.
يشير تقرير Stanford HAI لعام 202610 إلى ارتفاع الأداء على SWE-bench Verified من 60% إلى ما يقارب 100% خلال عام؛ وبتحليل فريق التالتة لهذه النتائج، يتوقع الفريق أداءً برمجيًا قويًا قياسًا بالعام السابق في المهام التي يقيسها المعيار. (hai.stanford.edu10)
ويعرض التقرير مثالًا آخر: حقق Gemini Deep Think مستوى الميدالية الذهبية في الأولمبياد الدولي للرياضيات، في مقابل دقة تبلغ 50.1% لأفضل نموذج في قراءة الساعات ذات العقارب. ويصنف التالتة النتيجة الثانية بأنها محدودة لهذه المهمة البصرية تحديدًا؛ فالقوة في الاستدلال الرياضي لا تضمن موثوقية متساوية في قراءة كل صورة. (hai.stanford.edu10)
النتيجة: الترتيب أداة لتكوين قائمة مرشحين، ثم تأتي المهمة والثقة والاستمرارية والقيمة لحسم الاشتراك.
جودة العربية: من يفهم النص والسياق السعودي أفضل؟
الأنسب للكتابة بالعربية وفهم السياق السعودي هو المساعد الذي يجمع بين سلامة اللغة والمحافظة على المعنى وملاءمة النبرة للجمهور.
ولهذا يقترح التالتة تقييم ثلاثة أمور منفصلة: سلامة اللغة، والمحافظة على المعنى، وملاءمة النبرة للجمهور. ويمكن أن يتضمن الاختبار صياغة رسالة لعميل، وتحرير وصف منتج، وتلخيص مستند عربي دون إضافة معلومات.
أما كتابة العربية داخل الصور فهي مهمة مختلفة. وينبغي فصل تقييمها عن تقييم جودة المقالات والمحادثات العربية.
النتيجة: يمنحك تطابق المساعد مع لغة عملك دليلًا أنفع لاختيار أفضل ذكاء اصطناعي من وصفه بأنه «يدعم العربية» فقط.
الثقة في الإجابة: متى تكفي المسودة؟
تكفي المسودة عندما تستطيع تحريرها وتقييمها، وتحتاج الإجابة إلى مصادر قابلة للفحص عندما يتوقف قرارك على صحة معلومة خارجية.
رسالة ترحيبية أو قائمة أفكار يمكن تحسينها بالتحرير. أما سعر الاشتراك، أو مواصفة منتج، أو استنتاج بحثي، فيحتاج إلى أصل يمكن الرجوع إليه.
وبالاتساق مع ضرورة الرجوع إلى أصل المعلومة، يكون تقييم التالتة عند اختيار أفضل ذكاء اصطناعي قويًا للإجابة التي تربط الادعاء بالمصدر المناسب وتفصل المؤكد عن التقدير، ومحدودًا للإجابة التي تكثر فيها الروابط دون أن تسند محتواها.
استمرارية العمل: هل الجودة المرتفعة كافية؟
الجودة المرتفعة لا تكفي إذا عطلت حدود الخطة مشروعك قبل إنجازه.
رأي مستخدمmiraworldus على يوتيوب: أوضح في تعليقه بتاريخ 21 يونيو 2026 أنه يستخدم الأداتين، لكن حدود Claude تقترب بالنسبة إليه من سبب كافٍ للاستغناء عنه؛ وهي تجربة فردية تلفت إلى أهمية الاستمرارية عند الشراء. رابط التعليق11
تفسر وثائق Anthropic7 تأثر الاستهلاك بالنموذج والميزات وطول المحادثة وتعقيدها. وبالتالي، يرى التالتة عند اختيار أفضل ذكاء اصطناعي أن إنهاء مشروع متكرر ضمن الحصة دليل أقوى على صلاحية الأداة للاشتراك من الإعجاب بمخرج واحد. (support.claude.com7)
النتيجة: تجربة المستخدم تنبه إلى سؤال مهم، وتحدد وثائق الخطة الإطار الذي يمكن تعميمه.
الأسعار: ما الذي يبرر الاشتراك المدفوع؟
يبرر الاشتراك المدفوع في أفضل ذكاء اصطناعي تختاره حصولك على قدرة أو استمرارية تحتاجها بصورة متكررة، مع فصل أسعار التطبيقات عن أسعار واجهات البرمجة.
الخطط المجانية: ما الذي تحصل عليه؟
تقدم خطة ChatGPT المجانية مجموعة واسعة من الوظائف، لكن لكل أداة شروط استخدام مستقلة.
توضح OpenAI2 إتاحة محادثات نصية يومية غير محدودة، مع ضوابط منع إساءة الاستخدام وحدود منفصلة لرفع الملفات والصور والصوت وتحليل البيانات. ويصنف التالتة ذلك بأنه قوي للمحادثة اليومية، مقابل مرونة أكثر تقييدًا عند الاعتماد المكثف على الأدوات. (help.openai.com2)
وتعرض الشركة سعة Library قدرها 500 ميغابايت للمستخدم المجاني؛ وهي سعة محدودة قياسًا باستخدام أرشيف عمل كبير، لكنها مفيدة للاحتفاظ بمواد منتقاة. كما توضح أن تطبيقات GPT تتوقف مؤقتًا عند بلوغ حد النموذج المتاح، وتعرض موعد تجدد الحد داخل المنتج. (help.openai.com2)
أما Claude، فتربط Anthropic7 حصصه بالخطة وطبيعة الاستهلاك؛ لذا لا يقدم عدد الرسائل وحده تقديرًا قويًا لكمية العمل الممكنة. (support.claude.com7)
النتيجة: يكفيك الإصدار المجاني من أفضل ذكاء اصطناعي تختاره عندما ينجز مهامك المتكررة، وتصبح الترقية منطقية عندما تعالج عائقًا محددًا.
أسعار المطورين: ماذا تعني تكلفة الرموز؟
تعني تكلفة الرموز الدفع مقابل الاستهلاك عبر API، وهي حساب مختلف عن الاشتراك الشهري في التطبيق.
تنشر Anthropic3 سعر Fable 5.2 وMythos 5.2 عند 8 دولارات لكل مليون رمز إدخال و40 دولارًا لكل مليون رمز إخراج. وتصفه بأنه أقل من الإصدارين السابقين؛ وهو تحسن قوي في تكلفة الوحدة عند اختيار أفضل ذكاء اصطناعي عبر API، غير أن فاتورة المهمة تتأثر أيضًا بحجم ما يقرأه النموذج وينتجه.
وتحدد الشركة الوضع السريع عند 16 دولارًا للإدخال و80 دولارًا للإخراج لكل مليون رمز، مقابل تسريع يصل إلى 2.5 مرة. ويصنف التالتة هذه المقايضة بأنها قوية للمهمات الحساسة للوقت، وأقل قيمة للأعمال التي يمكنها الانتظار.
النتيجة: السعر الأقل لكل مليون رمز لا يضمن المهمة الأرخص؛ الأهم هو تكلفة بلوغ نتيجة مقبولة.
التكلفة للمستخدم في السعودية: كيف تحسبها؟
تبدأ التكلفة الفعلية لاشتراك أفضل ذكاء اصطناعي تختاره من سعر الخطة المتاحة لحسابك، ثم تشمل أي رسوم أو ضرائب ظاهرة وفروق دورات الفوترة.
يمكنك حساب التكلفة بالريال من مبلغ الدفع النهائي للخطة المتاحة لحسابك، بدلًا من تحويل سعر تاريخي بالدولار. الأنسب لقرار الشراء هو مبلغ الدفع النهائي للخطة التي تمنحك النموذج والميزات المطلوبين، مع مراجعة التجديد بعد العروض.
ورصد الفريق التقني بمنصة التالتة اختلافًا بين أسعار اشتراكات التطبيقات وتكلفة API؛ ولذلك فصلت المقارنة بينهما لربط كل مبلغ بطريقة الاستخدام الصحيحة.
المميزات والقيود: ماذا تحصل عليه مقابل ما تدفعه؟
تظهر قيمة أفضل ذكاء اصطناعي تختاره عندما تتطابق ميزاته مع احتياج متكرر لديك.
- ChatGPT: تمنحه الأدوات التي توثقها OpenAI2 مرونة قوية للاستخدام المتنوع، مع ضرورة حساب حدود الملفات والصور والتحليل بصورة مستقلة.
- Claude: تدعم نتائج Anthropic3 ترشيحه للعمل التقني، ويجعل اختلاف الاستهلاك بحسب الجهد اختيار الإعداد جزءًا من إدارة التكلفة.
- Gemini: تمنحه تكاملاته قيمة عملية، لكن شروط Google للطرح4 تجعل الاستفادة من بعض الوظائف محدودة للحسابات خارج البلدان المدعومة.
- Jasper: تمنحه وظائف التسويق والحوكمة المعلنة في بيان الشركة5 قيمة أقوى للفرق من المستخدم الذي يريد مسودة عرضية.
- DALL-E: يساعد على تصور الأفكار بصريًا، وتوضح Productory8 أثر وضوح الوصف في النتيجة؛ ما يجعل الصياغة الدقيقة عاملًا مهمًا لتقليل المحاولات.
رأي مستخدمPlant-Baste على ريديت: شرح في 31 أكتوبر 2025 أن ChatGPT يساعده على تحويل أفكاره إلى مسودة أولية للوثائق التقنية، مع تأكيده أهمية عدم الوثوق به بالكامل؛ وهي شهادة مفيدة على قيمة تجاوز صعوبة البداية. رابط التعليق12
النتيجة: إعجابك بمخرج جميل سبب لتجربة الأداة، واستمرار فائدتها في مهامك سبب أقوى للاشتراك.
حالات الاستخدام: أي مساعد يناسب البحث والكتابة والبرمجة؟
يختلف أفضل ذكاء اصطناعي باختلاف الناتج الذي تحتاج إلى تسليمه وطريقة مراجعته.
أفضل مساعد لتحليل الصور هو ChatGPT؛ إذ يتيح للمستخدم المجاني رفع الصور والملفات ضمن مطالبه، وتحليل البيانات واستخلاص رؤى منها، مع استخدام Library بسعة تخزين 500 ميغابايت، وفق OpenAI2.
أفضل مساعد لتحليل الملفات هو ChatGPT؛ إذ يتيح ضمن الخطة المجانية رفع الصور والملفات، وتحليل البيانات واستخلاص رؤى منها، واستخدام Library بسعة تخزين 500 ميغابايت، وفق OpenAI2.
البحث: ما أفضل مساعد للمعلومات الموثقة؟
أفضل ذكاء اصطناعي للبحث هو الذي يساعدك على الوصول إلى مصادر أصلية وفحصها، وتبقى كثرة الإجابات أو الروابط معيارًا محدودًا وحدها.
تتيح OpenAI2 البحث على الويب ضمن الخطة المجانية؛ وهي نقطة بداية قوية للبحث الاستكشافي، لكن جودة الاستشهاد تحتاج إلى فحص مستقل عن إتاحة الميزة. (help.openai.com2)
اقرأ أيضًا: الذكاء الاصطناعي في الامارات وطفرة بقطاع الطيران المدني
رأي مستخدمanthonynathan7357 على يوتيوب: أفاد في 21 أكتوبر 2026 بأن Gemini قدم معلومات خاطئة في ست مقارنات متتالية أجراها رغم توافر المعلومات على مواقع الشركات؛ وهذه تجربة فردية توضح أهمية الرجوع إلى المصدر في المقارنات الست التي أجراها. رابط التعليق13
النتيجة: المسودة البحثية مفيدة لتنظيم العمل، ويأتي الاعتماد النهائي بعد مطابقة الادعاءات بمصادرها.
الكتابة بالعربية: ما الأداة الأنسب للمحتوى؟
أفضل ذكاء اصطناعي للمحتوى العربي هو الذي يحافظ على المعنى والنبرة ومتطلبات الجمهور بأقل تحرير.
يمكن للمستخدم الفردي اعتماد نتيجة اختبار نصوصه أساسًا للاختيار. أما فريق التسويق، فيستفيد من وظائف تنظيم المحتوى واتساقه؛ وهي نقطة تخصص تؤكدها Jasper5 في عرض منصتها.
وبتحليل التالتة لوظائف Jasper، يتوقع الفريق قيمة قوية لفرق التسويق مقارنة بالمستخدم الفردي الذي يريد مسودة عرضية، مع اعتماد نصوص العمل لتقييم جودة العربية.
البرمجة: ما أفضل مساعد لإنجاز مشروع؟
يمثل Claude مرشحًا قويًا لأفضل ذكاء اصطناعي للمشروعات التقنية، حيث تدعم نتائج الشركة المنشورة هذا الترشيح مع ربط القرار بنوع المشروع.
توضح Anthropic3 أن Fable 5.2 بلغ 49.1% عند مستوى Xhigh في FrontierCode 2.0، وتصفه بأنه أعلى أداء لنموذج مُصدر اختبرته. ويعد التالتة النتيجة قوية ضمن المقارنة المنشورة، دون نقلها إلى ترتيب مستقل شامل.
توصل مهندسونا بعد تحليل بيانات ووثائق تقنية منشورة حديثًا إلى أن Fable 5.2 مرشح قوي لأفضل ذكاء اصطناعي في مهمة التصميم الهندسي المقاسة؛ فقد سجل 83.5 في BenchCAD 2.1، مقابل 65.3 لـOpus 5.5 و44.4 لـFable 5.1، وهو تقدم يرجح فائدة أكبر لمن يعمل على هذا النوع من المسائل مقارنة بمن يريد شرح شيفرة قصيرة.
النتيجة: تتقدم قيمة المساعد البرمجي عندما ينتج تعديلًا صالحًا للمراجعة ويواصل إصلاحه وفق نتائج الفحص.
الملفات والصور: ما الفرق بين التحليل والتوليد؟
تحليل ملف أو صورة يهدف إلى فهم محتوى موجود، في حين يهدف توليد الصور إلى إنشاء محتوى جديد.
تؤكد OpenAI2 إتاحة رفع الصور والملفات وتحليل البيانات للمستخدم المجاني، وهو عرض قوي للاستكشاف الأولي، مع حدود استخدام منفصلة. (help.openai.com2)
أما DALL-E، فتتناول 3arabi.ai6 قدرته على توليد الصور من النصوص. وتتمثل فائدته الأساسية هنا في تصور فكرة أو مشهد، لا إثبات دقة قراءة جدول أو مستند.
اقرأ أيضًا: Claude Code من الفكرة إلى المراجعة: دليل الاستخدام والتصحيح
النتيجة: اختيار أفضل ذكاء اصطناعي للصور يبدأ بتحديد ما إذا كنت تريد فهم صورة أم إنشاءها.
متى تختار ChatGPT؟ للاستخدام المتنوع قبل التخصص
يناسبك ChatGPT عندما تحتاج إلى مساعد واحد يجمع بين الكتابة والبحث والملفات والصور والبيانات.
يمكنك اختيار Grok إذا كنت تبحث عن بديل لـChatGPT بسبب ميلٍ سياسي تلاحظه في إجاباته؛ ففي تعليق بتاريخ 7 نوفمبر 202614، أوضح penelopebranson3621 أن إجابات ChatGPT بدت له مائلة إلى اليسار، وأنه سمع أن Grok يلتزم بالحقائق دون آراء. أما الاستخدام المجاني بحدود، فهو متاح أيضًا لدى المساعدات الكبرى، بحسب رأي على كيورا15.
توثق OpenAI2 هذه الوظائف في خطته المجانية، ما يمنحه قيمة قوية كبداية قبل الالتزام باشتراك. وتصبح الترقية مبررة عندما تحتاج إلى قدرة متاحة في الخطة المدفوعة أو إلى حدود أعلى تخدم مشروعك المتكرر. (help.openai.com2)
رأي مستخدمsarahakld على ريديت: أوضحت في 29 يونيو 2026 أنها تدفع مقابل النسخة المدفوعة وتستخدم ChatGPT في هوايات متنوعة، منها تصميم الحدائق وإعداد صور لكتب تكتبها لأحفادها؛ وهي حالة توضح قيمة التنوع لمستخدم واحد. رابط التعليق16
النتيجة: يقوى ترشيح ChatGPT لأفضل ذكاء اصطناعي لاستخدامك عندما تتوزع مهامك على وظائف مختلفة وتستفيد منها بصورة مستمرة.
متى تختار ChatGPT-5.5؟ عند التأكد من النموذج المتاح لخطة حسابك
يناسبك اختيار نموذج بعينه عندما تعرف الميزة التي تحتاجها وتتأكد من وصول خطتك إليه.
ينبغي أولًا التفريق بين ChatGPT بوصفه منتجًا، واسم النموذج المستخدم داخله. وبهذا الخصوص، يمكنك تقييم ChatGPT-5.5 بمقارنة مواصفات النموذج وأسعاره الحالية ببقية الخيارات، بوصفه نموذجًا داخل ChatGPT.
وعلى هذا الأساس، يصنف التالتة الاستناد إلى الاسم وحده أساسًا محدودًا للشراء. القرار الأقوى لاختيار أفضل ذكاء اصطناعي يرتبط بالنموذج الظاهر في حسابك، والميزات التي تصل إليها، وقدرته على إنجاز مهمتك.
النتيجة: تتحدد قيمة الاشتراك الإضافية بالميزات المتاحة وقدرة النموذج على إنجاز مهمتك، بدلًا من الاعتماد على رقم إصدار أعلى أو اسم ضمن قائمة ترشيحات.
متى تختار Jasper AI؟ عندما يكون المحتوى عمل فريق
يناسب Jasper AI فرق التسويق الباحثة عن أفضل ذكاء اصطناعي لتنظيم إنتاج المحتوى واتساقه عبر الحملات.
تصف Jasper في بيانها الصادر بتاريخ 28 يناير 20265 منصتها بأنها منصة لوكلاء التسويق تشمل الحملات والتخصيص والتوطين والامتثال والحوكمة. ويرى التالتة أن هذا التخصص قوي للمؤسسات التي تتكرر لديها تلك العمليات، ومتوسط القيمة لمن يطلب نصًا منفردًا بين فترة وأخرى. (tmcnet.com5)
وتوضح الشركة استخدام نحو 20% من شركات Fortune 500 لمنصتها. ويعد التالتة هذا مؤشرًا قويًا على تبنيها المؤسسي وفق تصريحها، مع فصل الانتشار عن إثبات جودة كل نص أو ملاءمة العربية لكل نشاط.
النتيجة: يدفع فريق التسويق مقابل تنظيم العمل واتساقه بقدر ما يدفع مقابل إنشاء النصوص.
متى تختار DALL-E؟ عندما تحتاج إلى تحويل الفكرة إلى صورة
بما أن DALL-E ينشئ تصورات بصرية ورسومًا ومشاهد تعتمد على وصف نصي، فهو يناسبك عند البحث عن أفضل ذكاء اصطناعي لهذا الاستخدام.
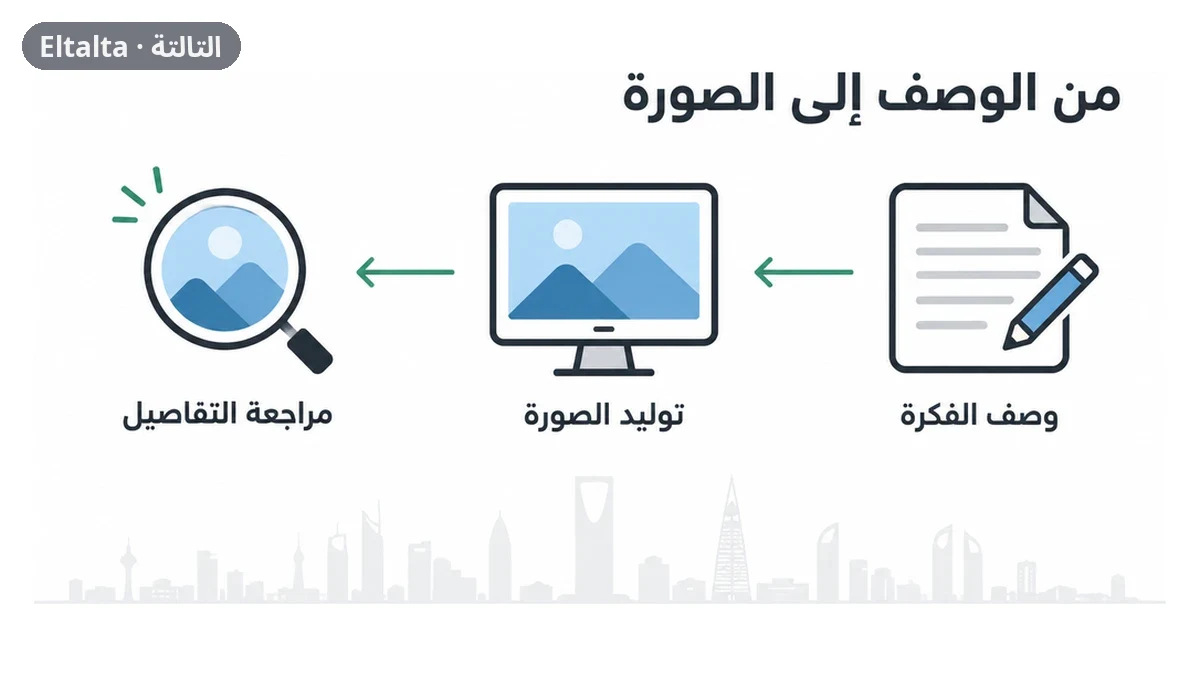
توضح Productory8 أن تحديد الفعل والسياق والقيود وزاوية الرؤية يحسن توجيه الصورة. وبتحليل التالتة، يكون الوصف المحدد أقوى من الوصف العام؛ لأن «كلبًا يلتقط كرة عند الغروب» يحدد فعلًا ومشهدًا لا توفرهما عبارة «كلب مع كرة».
وبتحليل فريق التالتة لنتيجة مراجعة ARWriter.ai، يتوقع الفريق أفضلية متوسطة لـDALL-E 3 على Gemini في كتابة العربية داخل الصور، مع الحاجة إلى مراجعة اتصال الحروف.
رأي مختصمراجع ARWriter.ai: منح DALL-E 3 نتيجة 7/10 في اختبار العربية، مقابل 5/10 لـGemini، بتاريخ 15 أبريل 2026، وأشار إلى عيوب طفيفة في اتصال الحروف لدى DALL-E 3. ويقرأ التالتة النتيجة بوصفها أفضلية متوسطة داخل تجربة المراجع وإصداراتها المحددة. رابط المراجعة17
النتيجة: تتضح فائدته في التصورات الإبداعية، وتحتاج المواد المنشورة إلى مراجعة النصوص والتفاصيل البصرية، خصوصًا عند تمثيل منتج حقيقي.
الإتاحة والخصوصية: ما الذي يهم المستخدم في السعودية؟
تبدأ ملاءمة أفضل ذكاء اصطناعي للمستخدم في السعودية بإتاحة المنتج والميزة والخطة، ثم شروط استخدام البيانات.
تدرج Anthropic18 المملكة العربية السعودية ضمن مناطقها المدعومة؛ وهو أساس قوي لإدراج Claude في قرار المقارنة المحلي، مع بقاء الوصول إلى النماذج مرتبطًا بشروط الخطط. (anthropic.com18)
وتوضح Google4 أن مراسلة Gemini عبر Google Messages أو iMessage تتطلب، في الطرح الموثق، مستخدمًا في الولايات المتحدة بعمر 18 عامًا فأكثر، وحسابًا شخصيًا ورقمًا أمريكيًا موثقًا وشركة اتصالات مؤهلة. ويصنف التالتة الاستفادة من هذه الميزة بأنها محدودة للمستخدم السعودي الذي لا يستوفي الشروط؛ فلا يصح احتسابها ضمن قيمة اشتراكه تلقائيًا. (gemini.google4)
وفي الخصوصية، تؤكد OpenAI19 تفعيل مشاركة البيانات افتراضيًا في مساحات العمل الشخصية لخطط Free وPlus وPro، مع إمكان إيقاف «تحسين النموذج للجميع» والاحتفاظ بالسجل. ويعد التالتة هذا تحكمًا مفيدًا، مع ضرورة فهم الاستثناءات. (help.openai.com19)
وتوضح الشركة احتمال استخدام المحادثة المرتبطة بالملاحظات لتدريب النماذج، كما تعرض استثناء جلسات Daybreak على الحساب الشخصي حتى عند تعطيل الخيار. وتصبح مراجعة هذه التفاصيل مهمة قبل رفع محتوى حساس. (help.openai.com19)
النتيجة: تقليل البيانات الحساسة إلى القدر اللازم ومراجعة الإعدادات يزيدان ملاءمة الأداة للعمل، ويكملان تقييم الجودة والسعر.
دراسة حالة: مشروع برمجي امتد ثمانية أيام
توضح حالة Anthropic أن تقييم أفضل ذكاء اصطناعي للعمل التقني يستفيد من النظر إلى قدرته على إدارة مشروع ممتد، إلى جانب جودة الإجابة المنفردة.
أفادت Anthropic في إعلان Fable 5.23 بأن مهندسًا بدأ تجربة من مجلد فارغ، ونسق النموذج أكثر من 1,000 وكيل فرعي عملوا لمدة ثمانية أيام على كتابة الشيفرة واختبارها ومراجعتها، وصولًا إلى نظام تشغيل عامل يقلع على حاسوب محمول. ويعد التالتة هذه حالة قوية على اتساع العمل المنجز في التجربة المنشورة، مع نسبتها إلى الشركة التي أجرتها.
ويستخلص التالتة منها معيارًا أقرب إلى قرار الشراء: هل تساعدك الأداة على متابعة المشروع وفحص أجزائه والمحافظة على تقدمه؟ عدد الوكلاء ومدة التشغيل يدلان أيضًا على حجم الموارد المستخدمة، ولذلك يقيّم المستخدم القيمة بتكلفة إنجاز مشروعه المطلوب. الأثر العملي لهذه الحالة هو توسيع المقارنة من جودة الإجابة الأولى إلى جودة العمل المستمر.
تحليل التالتة: تكلفة الجودة المطلوبة أهم من مطاردة أعلى نتيجة
يرى التالتة أن تكلفة الوصول إلى الجودة التي تتطلبها المهمة هي المعيار الأكثر فائدة لاختيار أفضل ذكاء اصطناعي، مع تحديد الحد المقبول مسبقًا.
تعرض تقييمات Anthropic3 أربع مقارنات بين Fable 5.2 وOpus 5.5 تدعم هذا التحليل:
| المهمة والمعيار | نتيجة Fable 5.2 | المقارنة مع Opus 5.5 | تكلفة المهمة النسبية | حكم التالتة |
|---|---|---|---|---|
| البرمجة: FrontierCode 2.0 | 45.3% عند High | 45.5% عند Max | نحو النصف | قيمة قوية مقابل فرق أداء طفيف |
| جمع البيانات: WANDR | يعادل أفضل نتيجة عند Medium | أفضل نتيجة لـOpus 5.5 | نحو 40% | قيمة قوية عند تساوي النتيجة المقاسة |
| المعرفة والاستدلال: Humanity’s Last Exam | يعادل أفضل نتيجة عند Low | أفضل نتيجة لـOpus 5.5 | أقل من العُشر | كفاءة تكلفة قوية جدًا في إعداد الاختبار |
| قراءة المخططات: Chartography | 66.4% عند Medium | 64.4% عند Max | أقل من العُشر | قيمة قوية تجمع تفوق النتيجة وانخفاض التكلفة |
حرص فريق مختبر التالتة على اختبار الأرقام المنشورة ومقارنتها حسابيًا؛ فالفارق في مقارنة البرمجة يبلغ 0.2 نقطة مئوية، وتصنفه قراءتنا بأنه محدود مقابل خفض يقارب نصف تكلفة المهمة وفق إعدادات الشركة.
اطلع مهندسو التالتة على مقارنة WANDR، وخلصوا بعد سلسلة مقارنات إلى أن بلوغ النتيجة المقاسة نفسها يحقق توفيرًا يقارب 60%. أما المقارنتان اللتان تنخفض فيهما التكلفة إلى أقل من العُشر، فتعنيان توفيرًا يتجاوز 90% ضمن شروطهما. وتشير هذه النسب إلى وفورات قوية في المهام وإعدادات الاختبار المذكورة.
ويمكن بناء قرار الاستخدام على مستويين: مستوى اقتصادي يحقق شرط القبول لمعظم العمل، ومستوى أعلى للمهمات التي يظهر فيها عجز واضح. لا تحتاج كل مهمة إلى أقصى جهد لمجرد توافره.
وتوضح Anthropic3 أنها أجرت الاختبارات المعروضة مع تشغيل وسائل الحماية، ما لم توضح خلاف ذلك، وأنها تستخدم أعلى مستوى جهد متاح ما لم تحدد إعدادًا آخر. لذلك يحافظ التالتة على أسماء مستويات الجهد عند المقارنة؛ لأنها جزء مؤثر من النتيجة والتكلفة.
النتيجة: الاشتراك الأعلى أو الإعداد الأعلى يستحق التكلفة عندما يرفع احتمال إنجاز مهمتك بالقدر الذي تحتاجه. أما الزيادة التي لا تغير صلاحية الناتج، فقد تكون إنفاقًا يمكن تجنبه.
الأسئلة الشائعة
ما أذكى نموذج ذكاء اصطناعي حاليًا؟
يتقاسم GPT-6.2 Astra وClaude Fable 5.2 صدارة الترتيب العام لاختبار LiveBench 2.0، ويتحدد الاختيار بحسب المهمة والإصدار والإعداد والتاريخ.
تنشر Anthropic3 نتائج قوية لـFable 5.2 في البرمجة والهندسة والاستدلال، لكنها تظل نتائج الشركة ضمن المقارنات التي عرضتها. ويعد التالتة الاستدلال منها على قوة تقنية محددة أقوى من تحويلها إلى حكم شامل.
ما الفرق بين DeepSeek وChatGPT عمليًا؟
تشمل المقارنة العملية بين DeepSeek وChatGPT لاختيار أفضل ذكاء اصطناعي وظائف التطبيق والحدود والاستمرارية والخصوصية، إلى جانب أداء نموذج الاستدلال.
وثقت الجزيرة نت في 17 فبراير 20259 منافسة DeepSeek R1 لنموذج OpenAI o1 وتقديمه مجانًا آنذاك. وتفيد هذه المقارنة التاريخية في فهم المنافسة، وتظل فائدتها محدودة عند المفاضلة بين إصدارات اليوم.
في المقابل، توثق OpenAI2 حاليًا وظائف البحث والملفات والصور والتحليل ضمن ChatGPT المجاني، مع حدود منفصلة؛ ما يجعل مقارنة التطبيقين مرتبطة بالأدوات التي تحتاجها أيضًا. (help.openai.com2)
ما أفضل بديل لـChatGPT؟
أفضل ذكاء اصطناعي بديل لـChatGPT هو الذي يحل مشكلة محددة تواجهك في استخدامه.
ترشح التالتة Claude للعمل التقني، وGemini للتكاملات المتاحة لك ضمن جوجل، وJasper لتنظيم التسويق، وDALL-E لتوليد الصور، استنادًا إلى وظائفها الموثقة.
كيف أتحقق من صحة إجابة المساعد؟
يمكنك تقييم صحة إجابة أفضل ذكاء اصطناعي تختاره بمطابقة الادعاءات الأساسية مع مصادرها وإعادة فحص النتيجة القابلة للاختبار.
- افتح الرابط الذي استشهد به المساعد.
- طابق الادعاء مع النص أو الجدول الأصلي.
- راجع التاريخ والإصدار والخطة والبلد.
- أعد الحسابات المهمة.
- افحص الشيفرة أو البيانات بالطريقة المناسبة.
- اطلب فصل الحقائق عن التقديرات عند اختلاطها.
هل أحتاج إلى أداتين مدفوعتين؟
يفيد الجمع بين أفضل ذكاء اصطناعي لمهامك وأداة ثانية عندما تؤدي كل واحدة وظيفة مهمة لا تغطيها الأخرى بالقيمة نفسها.
قد يستفيد فريق من مساعد عام ومنصة متخصصة في تنظيم التسويق. أما شراء اشتراكين لكتابة المسودات نفسها، فيحتاج إلى وفر واضح في الوقت أو تحسن مؤثر في الناتج حتى يبرر التكلفة.
ماذا عن Answer AI؟
يصنف التالتة Answer AI خيارًا محدودًا في مقارنة أفضل ذكاء اصطناعي قياسًا بالأدوات ذات الوثائق الأوضح، بسبب قلة المراجعات واختلاف بعض أسمائه داخل الوصف.
تعرض صفحة Answer AI على App Store20 تنزيلًا مجانيًا ومشتريات داخل التطبيق، وتشير إلى عدم توافر مراجعات كافية لعرض نظرة عامة. ويعد التالتة قاعدة التقييم هذه محدودة للمقارنة الشرائية، خصوصًا مع اختلاف بعض أسماء التطبيق داخل الوصف.
ما أفضل ذكاء اصطناعي في النهاية؟
أفضل ذكاء اصطناعي هو الذي ينجز مهامك المتكررة بجودة قابلة للتقييم وتكلفة تستطيع الاستمرار عليها.
يمثل ChatGPT بداية عملية للاستخدام المتنوع، ويستحق Claude المقارنة للعمل التقني، ويقوى Gemini بالتكاملات المتاحة لحسابك، وتظهر قيمة Jasper في فرق التسويق، ويخدم DALL-E إنشاء التصورات البصرية. ثم يحسم قرارك ما توفره الأداة في مشروعك الفعلي من وقت وتعديلات وتكلفة.
المنهجية: كيف بنى فريق التالتة هذه المقارنة؟
بنى فريق التالتة مقارنة أفضل ذكاء اصطناعي على الرصد الآلي للأسعار والمواصفات والآراء الموثقة، ثم ربط المعلومات بالمهمة والخطة والتاريخ.
قام فريق التالتة بتنظيم المادة المجمعة بتاريخ 21 نوفمبر 2026 حول ست أدوات أساسية، وأربعة معايير للقرار: ملاءمة المهمة والثقة والاستمرارية والقيمة. وفصل التحليل بين اشتراكات التطبيقات وأسعار API، وبين نتائج الاختبارات وآراء المستخدمين.
واستند قسم «تحليل التالتة» إلى أربع مقارنات منشورة لدى Anthropic3، مع المحافظة على مستويات الجهد والتكلفة النسبية وشروط عرض النتائج. كما ربط الدليل وظائف ChatGPT وحدوده بـوثائق OpenAI2، وإتاحة ميزات Gemini بـملاحظات Google الرسمية4، ودعم السعودية بـسياسة Anthropic للمناطق المدعومة18.
وتعبر أوصاف «قوي» و«متوسط» و«محدود» عن أحكام تحريرية للتالتة على دلالة المعلومات المنشورة واستخداماتها المحددة. وتحافظ شهادات المستخدمين على أصحابها وتواريخها وروابطها، وتستخدمها المقارنة لإيضاح أسئلة الشراء التي تفسرها الوثائق والبيانات.
أحدث خبر عن «أفضل ذكاء اصطناعي»
خلصت مراجعة علمية نشرتها مجلة «مولكيولار ميديسين» إلى أن نماذج الذكاء الاصطناعي تضاهي أداء الخبراء أو تتجاوزه في تشخيص السل باستخدام أشعة الصدر وتحليل المادة الوراثية للبكتيريا. وتبرز أهمية النتائج في إمكانية تسريع التشخيص واختيار العلاج المناسب، خصوصًا في المناطق محدودة الموارد، إذ تواجه الفحوص التقليدية صعوبات تشمل بطء النتائج والحاجة إلى مختبرات مجهزة وكوادر متخصصة.
وسجلت نماذج تحليل أشعة الصدر قيمًا تقترب من 0.95 إلى 0.99 على مقياس لقدرتها على التمييز بين المصابين وغير المصابين. وتجاوزت نتائج التنبؤ بمقاومة البكتيريا للأدوية 90 بالمئة وفق مؤشر يجمع دقة التنبؤ والقدرة على رصد الحالات. غير أن استخدامها في الرعاية اليومية يواجه عقبات أخلاقية وتنظيمية وعملية، ويتطلب التحقق من موثوقيتها وبيانات تدريب تمثل المرضى.
المصدر: Bioengineer.org — «مراجعة علمية: الذكاء الاصطناعي يضاهي الخبراء في تشخيص السل» — نُشر 05:54 – 21/11/2026 (الموافق 11 جمادى الآخرة 1448 هـ). ترجمة التالتة.
إنتل تعلن الفائزين بمهرجان التأثير العالمي للذكاء الاصطناعي لعام 2026
أعلنت شركة إنتل الفائزين بمهرجانها العالمي لتأثير الذكاء الاصطناعي لعام 2026، تكريمًا لطلاب ومطورين شباب يستخدمون هذه التقنية لمعالجة تحديات مجتمعية. وتشمل مشروعاتهم مساعدة الأشخاص ذوي الإعاقة على التواصل باستقلالية أكبر، والكشف المبكر عن حرائق الغابات، وتحسين الزراعة وتسهيل تعلم اللغات، وهي تطبيقات تمس احتياجات يومية في التواصل والتعليم والبيئة.
ومن بين المشروعات الفائزة مدرب للنطق يساعد اليابانيين على تعلم الإنجليزية دون اتصال بالإنترنت، مع إبقاء بيانات الصوت خاصة، وروبوت لرصد الآفات ونضج الطماطم داخل البيوت الزراعية. وفي مجال التواصل، يحوّل نظام لتتبع العين حركاتها إلى عبارات أساسية للأشخاص المصابين بالتصلب الجانبي الضموري (مرض يصيب الأعصاب المتحكمة في العضلات)، في حين يجمع نظام للإنذار المبكر بالحرائق بين أجهزة الاستشعار والكاميرات لتقديم تنبيهات واضحة.
المصدر: Intel — نُشر 06:16 – 21/11/2026 (الموافق 11 جمادى الآخرة 1448 هـ).
بيئة الرصد: متابعة فريق المنصة باستخدام التحليل اليدوي وتقنيات الرصد المعلوماتي المتقدم: أمازون السعودية، وصفحات المواصفات، وتعليقات علنية على ريديت، كيورا ويوتيوب.
المصادر (47)
- Fello AI — felloai.com
- help.openai.com: — help.openai.com
- Anthropic — anthropic.com
- Google — gemini.google
- Jasper في بيانها المنشور عبر TMCnet — tmcnet.com
- صفحة مواصفات DALL-E — 3arabi.ai
- support.claude.com: — support.claude.com
- Productory — productory.ai
- الجزيرة نت — aljazeera.net
- hai.stanford.edu: — hai.stanford.edu
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على ريديت عن ChatGPT — reddit.com
- تعليق على يوتيوب عن Google Gemini — youtube.com
- تعليق على يوتيوب عن ChatGPT — youtube.com
- تعليق على كيورا عن ChatGPT — quora.com
- تعليق على ريديت عن ChatGPT — reddit.com
- رابط المراجعة — arwriterai.com
- anthropic.com: — anthropic.com
- help.openai.com: — help.openai.com
- صفحة Answer AI على App Store — apps.apple.com
- صفحة مواصفات Claude — handicraftm.com
- صفحة مواصفات Google AI Plus — reddit.com
- تعليق على ريديت عن ChatGPT — reddit.com
- تعليق على يوتيوب عن Google Gemini — youtube.com
- تعليق على يوتيوب عن Google Gemini — youtube.com
- تعليق على يوتيوب عن Google Gemini — youtube.com
- تعليق على يوتيوب عن ChatGPT — youtube.com
- تعليق على يوتيوب عن ChatGPT — youtube.com
- تعليق على يوتيوب عن Google Gemini — youtube.com
- تعليق على يوتيوب عن Google AI Plus — youtube.com
- تعليق على يوتيوب عن ChatGPT — youtube.com
- تعليق على يوتيوب عن ChatGPT — youtube.com
- تعليق على يوتيوب عن Google AI Plus — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
- تعليق على يوتيوب عن Claude — youtube.com
نوع القالب المستخدم: مقارنة — النمط التحريري: التقرير التحليلي


